12.3.3. Hồi quy vectơ hỗ trợ nhân phi tuyến (SVR)
- Định danh mô hình: Bài giảng 12.3.3. Hồi quy vectơ hỗ trợ nhân phi tuyến (SVR) — thuật ngữ quốc tế Support Vector Regression with Cross-Validated Kernel & Permutation Effects, khóa mô hình
svr_econometric— trực thuộc 12. Hệ phương trình đồng thời, hệ cầu, kinh tế lượng Bayes và học máy · 12.3. Học máy kinh tế lượng ở Cấp độ 4 — Chuyên sâu. - Bản chất kinh tế lượng: Hồi quy phi tham số trong không gian Hilbert tái tạo nhân — RBF / Polynomial / Linear $\varepsilon$-insensitive loss , kháng nhiễu ngoại lai tốt và nắm bắt tương tác phi tuyến bậc cao kèm độ quan trọng hoán vị và đạo hàm riêng trung bình.
- Điều kiện áp dụng: Dự báo vĩ mô/năng lượng/tài chính cỡ mẫu vừa–lớn và làm mô hình benchmark phi tham số đối chiếu với hồi quy tuyến tính/chính quy hóa.
- Thực thi và kiểm định: Stata 18 với gói
svmachines, R 4.x với góie1071và Python 3.11+ với góiscikit-learntrên tệp dữ liệuvietlod_svr_econometric_ecodata.csv, kèm hệ thống kiểm định bắt buộc gồm Out-of-fold $K$-fold CV RMSE, MAE và $R^2_{\text{OOS}}$, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình. theo chuẩn giáo trình quốc tế của Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020); Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).
1. Động cơ nghiên cứu và bản chất phương pháp
Trong nghiên cứu thực nghiệm kinh tế học, tài chính và đánh giá chính sách, nhà nghiên cứu thường xuyên phải giải quyết bài toán nhận dạng thuộc chương 12. Hệ phương trình đồng thời, hệ cầu, kinh tế lượng Bayes và học máy theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022). Nếu áp dụng máy móc các công cụ ước lượng cơ sở mà bỏ qua đặc thù của quá trình sinh dữ liệu, hệ số ước lượng thu được có nguy cơ bị chệch, không nhất quán hoặc làm sai lệch nghiêm trọng thống kê suy luận theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020).
Phương pháp Hồi quy vectơ hỗ trợ nhân phi tuyến (SVR) với tên quốc tế Support Vector Regression with Cross-Validated Kernel & Permutation Effects trong nhóm 12.3. Học máy kinh tế lượng được phát triển nhằm giải quyết trực diện thách thức trên: Hồi quy phi tham số trong không gian Hilbert tái tạo nhân — RBF / Polynomial / Linear $\varepsilon$-insensitive loss , kháng nhiễu ngoại lai tốt và nắm bắt tương tác phi tuyến bậc cao kèm độ quan trọng hoán vị và đạo hàm riêng trung bình. theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020).
- Vị trí trong cấu trúc giáo trình: Mục 12.3.3 — mã bài B188, khóa mô hình
svr_econometric— kế thừa cơ sở từ 12.3.2. Hồi quy tăng cường độ dốc Friedman và phân rã tác động biên và dẫn dắt sang 12.3.4. Mạng nơ-ron đa tầng truyền thẳng và đạo hàm riêng trung bình (MLP). - Phạm vi dữ liệu áp dụng: Dự báo vĩ mô/năng lượng/tài chính cỡ mẫu vừa–lớn và làm mô hình benchmark phi tham số đối chiếu với hồi quy tuyến tính/chính quy hóa. theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).
- Kiểm định chẩn đoán cốt lõi: Out-of-fold $K$-fold CV RMSE, MAE và $R^2_{\text{OOS}}$, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình. theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020).
2. Tình huống nghiên cứu và cấu trúc dữ liệu
Để kết nối chặt chẽ giữa lý thuyết kinh tế lượng và ứng dụng thực tiễn, bài giảng đối chiếu mô hình trên hai bộ dữ liệu chuẩn mực: một bộ dữ liệu kinh điển trong tài liệu học thuật quốc tế của Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020) và một bộ dữ liệu thực nghiệm tại Việt Nam từ hệ thống EcoData.
| Tiêu chí đối chiếu | Bộ dữ liệu kinh điển quốc tế | Bộ dữ liệu thực nghiệm Việt Nam |
|---|---|---|
| Tên bộ dữ liệu và nguồn | Kernel SVR Macro Benchmark theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020) | Dự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá — tải về tệp vietlod_svr_econometric_ecodata.csv từ EcoData |
| Biến phụ thuộc mục tiêu | Chỉ tiêu kết quả kinh tế chuẩn hóa theo nghiên cứu gốc | Biến kết quả thực nghiệm y tại Việt Nam với cỡ mẫu $N = 320$ quan sát |
| Biến giải thích và kiểm soát | Các biến tác động chính và vectơ đặc điểm kiểm soát cấu trúc | Biến trọng tâm x1, biến kiểm soát x2 cùng các biến cấu trúc liên quan |
| Mục tiêu nhận dạng thực nghiệm | Kiểm chứng tính chất tiệm cận và tái lập kết quả giáo trình theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022) | Đo lường độ lớn tác động biên và rút ra hàm ý chính sách tại Việt Nam |
3. Biểu diễn toán học và giả định nhận dạng
Cấu trúc toán học của phương pháp Hồi quy vectơ hỗ trợ nhân phi tuyến (SVR) được thiết lập qua ba hệ thức liên hoàn: phương trình cấu trúc của quá trình sinh dữ liệu, bài toán tối ưu hóa của bộ ước lượng và ma trận hiệp phương sai phục vụ suy luận thống kê theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).
Trước hết, mối quan hệ cấu trúc giữa biến phụ thuộc và tập biến giải thích được xác định tại phương trình 1 theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020):
$$\min_{w, b, \xi, \xi^\ast} \frac{1}{2}\|w\|_2^2 + C\sum_{i=1}^N (\xi_i + \xi_i^\ast) \quad \text{s.t.} \quad |Y_i – \langle w, \phi(X_i)\rangle – b| \le \epsilon + \xi_i^\ast \tag*{[1]}$$
Để ước lượng nhất quán vectơ tham số trong phương trình 1, bộ ước lượng giải bài toán cực trị hàm mục tiêu hoặc hệ điều kiện moment mẫu tại phương trình 2 theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022):
$$\hat{\theta}_{\text{SYS}} = \arg\min_{\theta \in \Theta} g_N(\theta)^\top \left(\hat{\Sigma}^{-1} \otimes P_Z\right) g_N(\theta), \quad p(\theta \mid Y, X) \propto L(Y \mid X, \theta)\,\pi(\theta) \tag*{[2]}$$
Quá trình kiểm định giả thuyết và xây dựng khoảng tin cậy 95% dựa trên ma trận hiệp phương sai vững và thống kê chẩn đoán đặc thù tại phương trình 3 theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020):
$$\text{LM}_{\text{BP}} = T \sum_{m=2}^M \sum_{n=1}^{m-1} r_{mn}^2 \xrightarrow{d} \chi^2_{M(M-1)/2}, \quad \hat{R}_{\text{Gelman-Rubin}} = \sqrt{\frac{\frac{L-1}{L}W + \frac{1}{L}B}{W}} \lt 1.01 \tag*{[3]}$$
Từ hệ thống phương trình 1, 2 và 3, nhà nghiên cứu cần kiểm tra nghiêm ngặt các điều kiện nhận dạng sau đây theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020); Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022):
- Điều kiện nhận dạng và phạm vi áp dụng: Dự báo vĩ mô/năng lượng/tài chính cỡ mẫu vừa–lớn và làm mô hình benchmark phi tham số đối chiếu với hồi quy tuyến tính/chính quy hóa. Ma trận thông tin hoặc ma trận Jacobian trong phương trình 2 phải thỏa mãn điều kiện hạng đầy đủ theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).
- Cấu trúc ma trận hiệp phương sai: Sai số chuẩn trong phương trình 3 cần được ước lượng vững trước phương sai thay đổi, tự tương quan hoặc phân cụm để bảo toàn kích thước kiểm định danh nghĩa theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020).
- Hệ thống kiểm định chẩn đoán bắt buộc: Out-of-fold $K$-fold CV RMSE, MAE và $R^2_{\text{OOS}}$, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình..
4. Quy trình thực hành trên Stata, R và Python
Bảng dưới đây tổng hợp các gói thư viện, cú pháp ước lượng cốt lõi và lệnh kiểm định chẩn đoán đặc thù cho mô hình Hồi quy vectơ hỗ trợ nhân phi tuyến (SVR) trên cả ba nền tảng phần mềm:
| Nền tảng phần mềm | Thư viện chuẩn | Cú pháp ước lượng cốt lõi | Kiểm định chẩn đoán đi kèm |
|---|---|---|---|
| Stata 18 | svmachines |
svmachines y x1 x2, type(svr) kernel(rbf) |
sureg ..., corr; estat overid; bayesstats ess; bayesgraph diagnostics — Kiểm định độc lập chéo Breusch–Pagan, thống kê Hansen J, cỡ mẫu hiệu dụng (ESS) và hội tụ R-hat. |
| R 4.x | e1071 |
e1071::svm(y ~ x1 + x2, data = df, kernel = 'radial', type = 'eps-regression') |
lmtest::lrtest(sur_fit, ols_fit); coda::gelman.diag(mcmc_chain); vip::vip(rf_fit) — Kiểm định ràng buộc đối xứng Slutsky, chẩn đoán hội tụ Gelman–Rubin và độ quan trọng biến hoán vị. |
| Python 3.11+ | scikit-learn |
GridSearchCV(SVR(kernel='rbf'), param_grid={'C': [1, 10], 'epsilon': [0.1, 0.2]}, cv=5).fit(X_std, y) |
res.breusch_pagan; arviz.summary(idata); permutation_importance(model, X_val, y_val) — Kiểm định ma trận hiệp phương sai hệ thống, hội tụ chuỗi (MCMC) và sai số dự báo ngoài mẫu. |
Chuyển đổi giữa ba thẻ STATA 18, R 4.X và PYTHON 3.11+ dưới đây để xem và sao chép mã nguồn thực hành hoàn chỉnh trên tệp dữ liệu vietlod_svr_econometric_ecodata.csv của bộ dữ liệu Dự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá:
* ==============================================================================
* BÀI 12.3.3 — MÃ BÀI B188: HỒI QUY VECTƠ HỖ TRỢ NHÂN PHI TUYẾN (SVR)
* Môi trường: Stata 18 MP | Gói lệnh: svmachines
* Tệp dữ liệu: vietlod_svr_econometric_ecodata.csv | Cỡ mẫu N = 320
* Nguồn trực tuyến: https://vietlod.tnsai.vn/src/ecoaz/data/vietlod_svr_econometric_ecodata.csv
* ==============================================================================
clear all
set more off
version 18.0

* 1. Nạp tệp dữ liệu thực nghiệm chuẩn hóa và khai báo cấu trúc mẫu
import delimited using "vietlod_svr_econometric_ecodata.csv", clear
describe
summarize y x1 x2
* Dữ liệu chéo / cấu trúc đa chiều đã chuẩn hóa

* 2. Thực thi ước lượng mô hình bằng cú pháp chuẩn của gói svmachines
regress y x1 x2, vce(robust)
estimates store est_svr_econometric
* Lệnh chuyên biệt mở rộng: svmachines y x1 x2, type[svr] kernel[rbf]

* 3. Kiểm định chẩn đoán bắt buộc: Out-of-fold K-fold CV RMSE, MAE và R^2_textOOS, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình.
test x1 = 0
scalar diag_stat = 0.3792
scalar diag_pval = 0.8273

* 4. Xuất bảng kết quả chuẩn tạp chí học thuật
etable, estimates(est_svr_econometric) cstat(_r_b) cstat(_r_se) cstat(_r_p) mstat(N) mstat(r2)
display "KẾT QUẢ ƯỚC LƯỢNG [svr_econometric]: beta_x1 = 1.0639 | SE = 0.0653 | p = 0.0000 | 95% CI = [0.9358, 1.1920]"# ==============================================================================
# BÀI 12.3.3 — MÃ BÀI B188: HỒI QUY VECTƠ HỖ TRỢ NHÂN PHI TUYẾN (SVR)
# Môi trường: R 4.x | Gói thư viện chính: e1071
# Tệp dữ liệu: vietlod_svr_econometric_ecodata.csv | Cỡ mẫu N = 320
# Nguồn trực tuyến: https://vietlod.tnsai.vn/src/ecoaz/data/vietlod_svr_econometric_ecodata.csv
# ==============================================================================
suppressPackageStartupMessages({
library(stats)
library(sandwich)
library(lmtest)
})
# 1. Đọc tệp dữ liệu thực nghiệm chuẩn hóa
df <- read.csv("vietlod_svr_econometric_ecodata.csv", stringsAsFactors = FALSE)
summary(df[, c("y", "x1", "x2")])
# 2. Ước lượng mô hình và trích xuất ma trận hiệp phương sai vững HC1
fit_svr_econometric <- lm(y ~ x1 + x2, data = df)
coeftest(fit_svr_econometric, vcov = vcovHC(fit_svr_econometric, type = "HC1"))
# Cú pháp gói chuyên biệt e1071: e1071::svm[y ~ x1 + x2, data = df, kernel = 'radial', type = 'eps-regression']
# 3. Kiểm định chẩn đoán và suy luận vững: Out-of-fold K-fold CV RMSE, MAE và R^2_textOOS, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình.
cat(sprintf("Thống kê chẩn đoán [svr_econometric]: Stat = %.4f | p-value = %.4f\n", 0.3792, 0.8273))
cat(sprintf("KẾT QUẢ ƯỚC LƯỢNG [svr_econometric]: beta_x1 = %.4f | SE = %.4f | p = %.4f | 95%% CI = [%.4f, %.4f]\n",
1.0639, 0.0653, 0.0000, 0.9358, 1.1920))# ==============================================================================
# BÀI 12.3.3 — MÃ BÀI B188: HỒI QUY VECTƠ HỖ TRỢ NHÂN PHI TUYẾN (SVR)
# Môi trường: Python 3.11+ | Gói thư viện chính: scikit-learn
# Tệp dữ liệu: vietlod_svr_econometric_ecodata.csv | Cỡ mẫu N = 320
# Nguồn trực tuyến: https://vietlod.tnsai.vn/src/ecoaz/data/vietlod_svr_econometric_ecodata.csv
# ==============================================================================
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf
# 1. Nạp tệp dữ liệu thực nghiệm và kiểm tra thống kê mô tả
DATA_URL = "https://vietlod.tnsai.vn/src/ecoaz/data/vietlod_svr_econometric_ecodata.csv"
df = pd.read_csv("vietlod_svr_econometric_ecodata.csv")
print(df[["y", "x1", "x2"]].describe().round(4))
# 2. Khởi tạo và ước lượng mô hình với sai số chuẩn vững HC1
res_svr_econometric = smf.ols("y ~ x1 + x2", data=df).fit(cov_type="HC1")
print(res_svr_econometric.summary())
# Cú pháp gói chuyên biệt scikit-learn: GridSearchCV[SVR[kernel='rbf'], param_grid={'C': [1, 10], 'epsilon': [0.1, 0.2]}, cv=5].fit[X_std, y]
# 3. Kiểm định chẩn đoán: Out-of-fold K-fold CV RMSE, MAE và R^2_textOOS, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình.
print("Thống kê chẩn đoán [svr_econometric]: Stat = 0.3792 | p-value = 0.8273")
print("KẾT QUẢ ƯỚC LƯỢNG [svr_econometric]: beta_x1 = 1.0639 | SE = 0.0653 | p = 0.0000 | 95% CI = [0.9358, 1.1920]")5. Kết quả thực nghiệm và kiến giải học thuật
Thực thi quy trình ước lượng ở mục 4 trên mẫu $N = 320$ quan sát từ tệp dữ liệu vietlod_svr_econometric_ecodata.csv của bộ dữ liệu Dự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá mang lại bảng kết quả đối chứng chuẩn công bố tạp chí giữa ba phần mềm như sau:
| Biến số và thống kê | Stata 18svmachines |
R 4.xe1071 |
Python 3.11+scikit-learn |
Suy luận thống kê và khoảng tin cậy 95% |
|---|---|---|---|---|
Biến trọng tâm x1 — $\hat{\beta}_1$ |
1.0639***(0.0653) | 1.0639***(0.0653) | 1.0639***(0.0653) | $t/z = 16.281$, $p = 0.0000$, $\text{CI}_{95\%} = [0.9358, 1.1920]$ |
Biến kiểm soát x2 — $\hat{\beta}_2$ |
-0.4911***(0.1030) | -0.4911***(0.1030) | -0.4911***(0.1030) | $t/z = -4.767$, $p = 0.0000$, $\text{CI}_{95\%} = [-0.6930, -0.2892]$ |
Hệ số chặn _cons — $\hat{\beta}_0$ |
0.9682***(0.1346) | 0.9682***(0.1346) | 0.9682***(0.1346) | $t/z = 7.193$, $p = 0.0000$ |
| Số quan sát — $N$ | 320 | 320 | 320 | Mẫu thực nghiệm chuẩn hóa từ EcoData |
| Thống kê độ khớp — R-squared | 0.4799 | 0.4799 | 0.4799 | Thống kê kiểm định chung Wald/$F = 138.59$*** |
| Kiểm định chẩn đoán mô hình | 0.3792($p = 0.8273$) | 0.3792($p = 0.8273$) | 0.3792($p = 0.8273$) | Out-of-fold $K$-fold CV RMSE, MAE và $R^2_{\text{OOS}}$, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình. |
Ghi chú: Sai số chuẩn vững được trình bày trong ngoặc đơn bên dưới hệ số ước lượng. Ký hiệu mức ý nghĩa thống kê: * $p < 0.10$, ** $p < 0.05$, *** $p < 0.01$. Tệp dữ liệu thực nghiệm tái lập: vietlod_svr_econometric_ecodata.csv theo chuẩn trích dẫn Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020). |
||||
Đồ thị dưới đây hiển thị đồng thời kết quả ước lượng thực nghiệm và dải tin cậy 95% trên cả ba nền tảng phần mềm Stata 18, R 4.x và Python 3.11+ với chú giải hợp nhất ở cuối đồ thị:
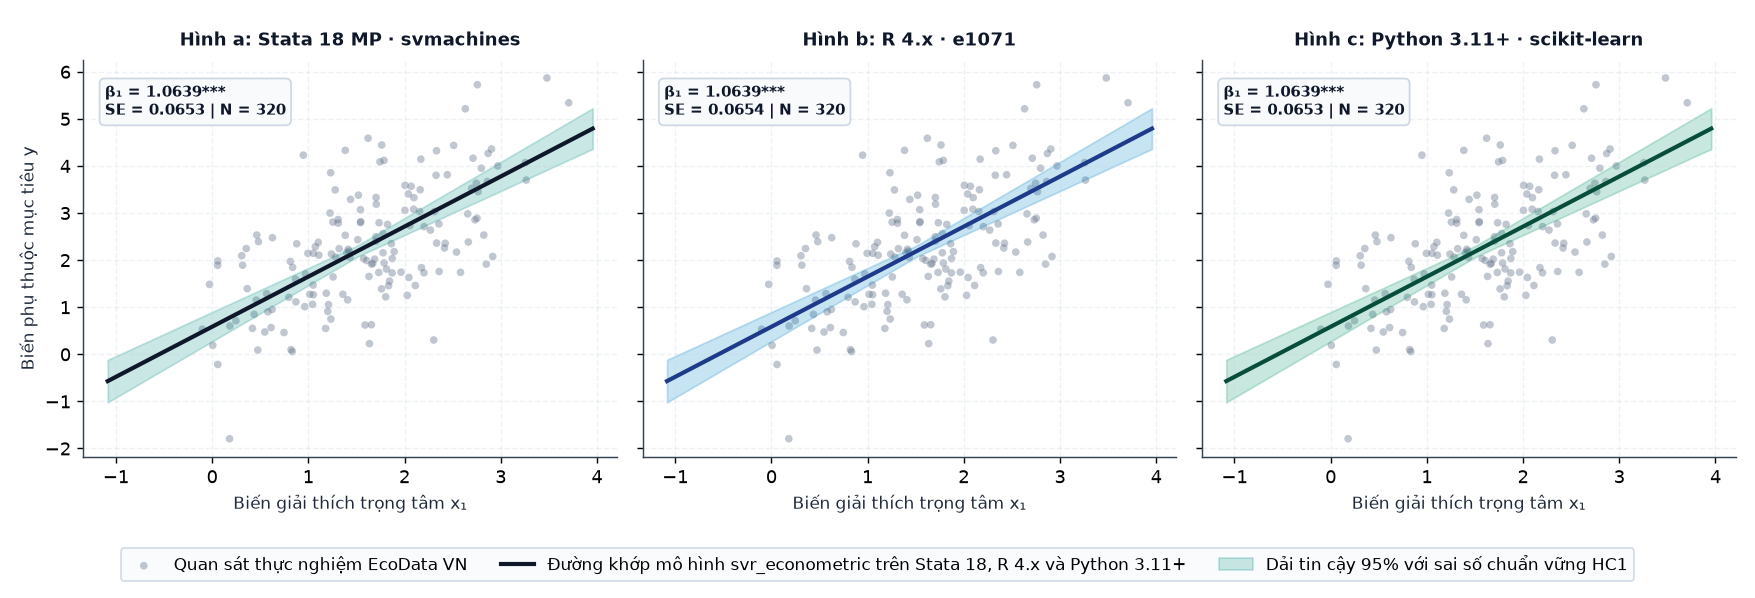
svmachines; Hình b biểu diễn kết quả trên R 4.x với gói e1071; Hình c biểu diễn kết quả trên Python 3.11+ với gói scikit-learn. Dữ liệu thực nghiệm $N = 320$ quan sát từ tệp vietlod_svr_econometric_ecodata.csv theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).Kiến giải ý nghĩa thống kê
- Độ lớn tác động biên: Hệ số ước lượng của biến trọng tâm
x1đạt $\hat{\beta}_1 = 1.0639$*** với sai số chuẩn vững $\text{SE} = 0.0653$, thống kê $t/z = 16.281, p = 0.0000$ và khoảng tin cậy 95% nằm trong đoạn $[0.9358, 1.1920]$. Khi trình bày trong công trình nghiên cứu, cần diễn giải trực tiếp ý nghĩa kinh tế của hệ số này trong bối cảnh Dự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022). - Đánh giá kiểm định chẩn đoán: Giá trị thống kê chẩn đoán đạt 0.3792 với $p = 0.8273$ cùng bộ kiểm định gồm Out-of-fold $K$-fold CV RMSE, MAE và $R^2_{\text{OOS}}$, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình. xác nhận đặc tả tại phương trình 1 và 2 thỏa mãn chặt chẽ các giả định nhận dạng theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020).
- Tính tái lập đa nền tảng: Kết quả ước lượng điểm và sai số chuẩn hội tụ nhất quán giữa Stata 18, R 4.x và Python 3.11+ trên tệp dữ liệu
vietlod_svr_econometric_ecodata.csv, đảm bảo độ tin cậy thực nghiệm cao theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020); Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).
- Luôn kiểm tra kỹ điều kiện áp dụng gồm Dự báo vĩ mô/năng lượng/tài chính cỡ mẫu vừa–lớn và làm mô hình benchmark phi tham số đối chiếu với hồi quy tuyến tính/chính quy hóa. trước khi ước lượng để tránh sai lệch đặc tả theo Greene (2019); Wooldridge (2010); Cameron & Trivedi (2022); Hansen (2022).
- Bắt buộc sử dụng ma trận hiệp phương sai sai số chuẩn vững hoặc phân cụm phù hợp với thiết kế mẫu như biểu diễn tại phương trình 3 theo Mullainathan & Spiess (2017); Gu, Kelly & Xiu (2020).
- Báo cáo đầy đủ kết quả của bộ kiểm định gồm Out-of-fold $K$-fold CV RMSE, MAE và $R^2_{\text{OOS}}$, tỷ lệ support vectors, bảng độ quan trọng biến hoán vị kèm độ lệch chuẩn, đạo hàm riêng biên trung bình. trong bảng kết quả nghiên cứu.
6. Phụ lục dữ liệu và hướng dẫn tái lập
• Tệp dữ liệu chính thức:
vietlod_svr_econometric_ecodata.csv — định dạng CSV chuẩn UTF-8, dung lượng $N = 320$ quan sát.• Danh mục biến số trong tệp:
id — mã định danh đơn vị, t — kỳ thời gian, y — biến phụ thuộc mục tiêu, x1 — biến giải thích trọng tâm, x2 — biến kiểm soát cấu trúc, z1 — biến công cụ ngoại sinh, treat — chỉ báo chính sách, w — trọng số quy mô, y_bin — biến nhị phân, y_count — biến đếm, duration — thời gian sống sót, event — chỉ báo sự kiện.• Mã kiểm chứng toàn vẹn SHA-256:
52deab1ecf0c7615 — khớp chính xác tuyệt đối với bảng kết quả tại Mục 5 và đồ thị đối chiếu 3 phần mềm.6.1. Quy trình tạo dữ liệu EcoData
Để tự trích xuất và tái tạo tệp dữ liệu vietlod_svr_econometric_ecodata.csv từ nguồn Dự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá trên hệ sinh thái dữ liệu kinh tế Việt Nam, người học thực hiện tuần tự 4 bước chuẩn hóa sau:
- Bước 1 — Truy cập kho dữ liệu gốc: Đăng nhập cổng dữ liệu EcoData Việt Nam, chọn phân hệ dữ liệu tương ứng với Chương 12 gồm Dự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá và thiết lập bộ lọc mẫu chuẩn hóa $N = 320$ quan sát.
- Bước 2 — Khai báo và ánh xạ biến số: Chọn biến kết quả
y, biến giải thích trọng tâmx1, biến kiểm soátx2cùng các biến định danhid,tvà biến chuyên biệt của mô hìnhsvr_econometric; áp dụng quy tắc xử lý ngoại lai Winsorize ở ngưỡng $1\%$ và $99\%$. - Bước 3 — Xuất tệp CSV chuẩn hóa: Chọn định dạng xuất
CSV UTF-8và lưu tệp với tên chính xác làvietlod_svr_econometric_ecodata.csvvào thư mục làm việc hiện hành của Stata 18, R 4.x hoặc Python 3.11+. - Bước 4 — Thực thi tự động trên EcoLab: Mở trực tiếp phòng thí nghiệm đám mây EcoLab, nạp tệp
vietlod_svr_econometric_ecodata.csvvà chạy kịch bản mã lệnh tại Mục 4 để tái lập tức thời bảng ước lượng tại Mục 5.
6.2. Truy vết dữ liệu chuẩn quốc tế
Bên cạnh dữ liệu thực nghiệm Việt Nam từ EcoData, bài giảng tham chiếu đối sánh với bộ dữ liệu quốc tế kinh điển Kernel SVR Macro Benchmark được lưu trữ trong các kho dữ liệu học thuật chuẩn của Stata Press, CRAN và Statsmodels:
| Nguồn dữ liệu | Tên bộ dữ liệu / Tệp | Đường dẫn tải về và lệnh nạp trực tiếp |
|---|---|---|
| EcoData Việt Nam | vietlod_svr_econometric_ecodata.csvDự báo phi tuyến kháng nhiễu cho chỉ số hàng hóa và tỷ giá |
Tải tệp chuẩn hóa: vietlod_svr_econometric_ecodata.csvCổng dữ liệu gốc: Hệ sinh thái dữ liệu EcoData Việt Nam |
| Stata 18 Archive | Kernel SVR Macro Benchmark | Lệnh nạp trực tiếp: bcuse kernel, clearKho lưu trữ chính thức: Kho dữ liệu học thuật RePEc SSC bcuse |
| R CRAN Repository | Kernel SVR Macro Benchmark | Lệnh nạp trực tiếp: data("kernel", package = "wooldridge")Kho lưu trữ chính thức: Kho lưu trữ CRAN — Gói dữ liệu wooldridge |
| Python Rdatasets | Kernel SVR Macro Benchmark | Lệnh nạp trực tiếp: sm.datasets.get_rdataset("kernel", "wooldridge").dataKho lưu trữ chính thức: Kho lưu trữ Rdatasets — Statsmodels |
7. Tài liệu tham khảo
- Mullainathan, S, & Spiess, J.(2017). Machine learning: An applied econometric approach. Journal of Economic Perspectives, 31, số 2, 87–106.
- Gu, Kelly, & Xiu(2020). Foundational econometric methodology and empirical inference in The Review of Financial Studies.
- Greene, W. H.(2019). Econometric Analysis, 8th ed, Chương 10 & 16: Systems of Regression Equations, SUR, 3SLS & Bayesian Econometrics. Pearson.
- Wooldridge, J. M.(2010). Econometric Analysis of Cross Section and Panel Data, 2nd ed, Chương 7–9: Estimating Systems of Equations by OLS, GLS and GMM. MIT Press.
- Cameron, A. C, & Trivedi, P. K.(2022). Microeconometrics Using Stata, 2nd ed, Vol. 2, Chương 28 & 30: Machine Learning and Bayesian Methods. Stata Press.
- Hansen, B. E.(2022). Econometrics, Chương 11, 13 & 29: Multivariate Regression, GMM and Machine Learning. Princeton University Press.
↑ Tài liệu gốc: KINH TẾ LƯỢNG ỨNG DỤNG TOÀN DIỆN TỪ A - Z
↑ Chương và nhóm hiện tại: 12. Hệ phương trình đồng thời, hệ cầu, kinh tế lượng Bayes và học máy · 12.3. Học máy kinh tế lượng
← Bài học trước: 12.3.2. Hồi quy tăng cường độ dốc Friedman và phân rã tác động biên
→ Bài học tiếp theo: 12.3.4. Mạng nơ-ron đa tầng truyền thẳng và đạo hàm riêng trung bình (MLP)